Abstract high-tech visualization of a neural network with gl

Struktur und Funktion Neuronaler Netze

Eine tiefgehende technische Analyse der mathematischen Modelle, die das Fundament moderner künstlicher Intelligenz bilden. Erfahren Sie mehr über die Mechanismen des Deep Learning und die Architektur künstlicher Neuronen.

Die Anatomie des Perzeptrons

Das künstliche Neuron, oft als Perzeptron bezeichnet, stellt die kleinste Recheneinheit innerhalb eines neuronalen Netzes dar. Es empfängt mehrere Eingangssignale, die jeweils mit einem spezifischen Gewicht (Weight) versehen werden. Diese Gewichte bestimmen die Relevanz des jeweiligen Inputs für das Endergebnis. Ein Bias-Wert wird addiert, um die Aktivierungsschwelle des Neurons flexibel zu verschieben.

Die gewichtete Summe der Eingänge wird anschließend durch eine Aktivierungsfunktion transformiert. Dieser Prozess ist entscheidend, um Nichtlinearität in das System einzuführen, was es dem Netzwerk ermöglicht, komplexe Muster zu erkennen, die über einfache lineare Regressionen hinausgehen. Ohne diese Funktionen wäre ein tiefes Netz lediglich eine Kombination linearer Transformationen.

Input-Vektor (x):
Die Rohdaten oder Signale aus der vorherigen Schicht.
Gewichtungsmatrix (W):
Parameter, die während des Trainings angepasst werden.
Summationsfunktion:
Berechnung von ∑(w_i * x_i) + b.
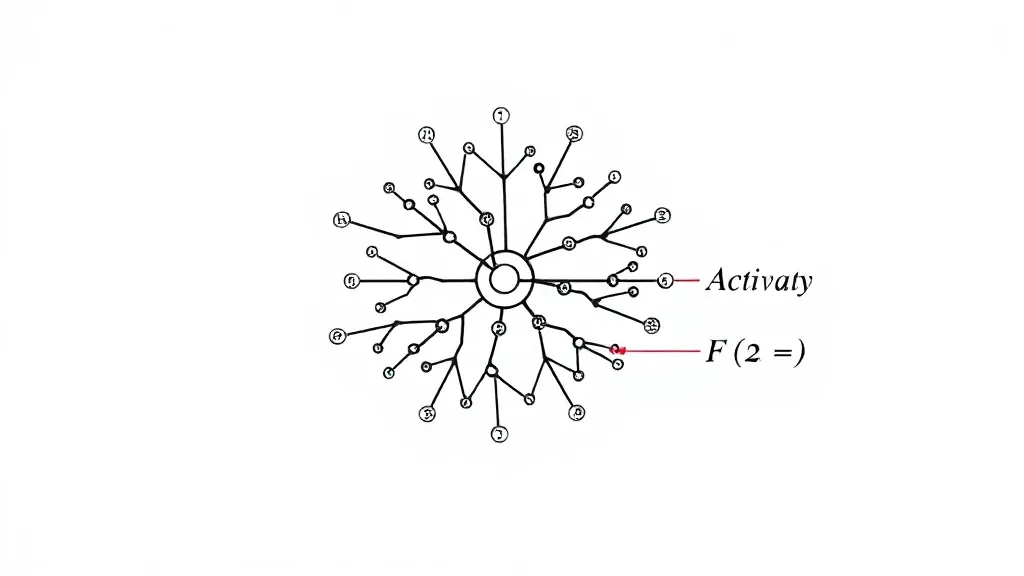
Diagram of a single artificial neuron showing inputs, weight

Häufig gestellte Fragen zu Deep Learning

Was unterscheidet Deep Learning von klassischem Machine Learning?

Deep Learning nutzt mehrschichtige neuronale Netze, die Merkmale (Features) automatisch aus Rohdaten extrahieren können. Im Gegensatz dazu erfordert klassisches Machine Learning oft manuelles Feature-Engineering durch Experten.

Warum sind GPUs für das Training so wichtig?

Neuronale Netze bestehen aus Milliarden von Matrix-Multiplikationen. Grafikprozessoren (GPUs) sind auf parallele Berechnungen spezialisiert und können diese Operationen um den Faktor 10 bis 100 schneller ausführen als herkömmliche CPUs.

Was versteht man unter Overfitting?

Overfitting tritt auf, wenn ein Modell die Trainingsdaten "auswendig lernt", anstatt allgemeine Muster zu erkennen. Dies führt zu einer hohen Genauigkeit im Training, aber zu einer schlechten Leistung bei neuen, unbekannten Daten.

Mathematical formulas of calculus and gradients on a dark di

Der Backpropagation-Algorithmus

Backpropagation ist das Herzstück des Lernprozesses in tiefen Netzen. Es handelt sich um ein Verfahren des überwachten Lernens, das auf der Kettenregel der Differentialrechnung basiert. Nachdem ein Input das Netzwerk durchlaufen hat (Forward Pass), wird die Differenz zwischen der Vorhersage und dem tatsächlichen Zielwert berechnet – die sogenannte Verlustfunktion (Loss Function).

"Backpropagation ermöglicht es uns, den Fehlergradienten effizient von der Ausgangsschicht zurück durch alle verborgenen Schichten zu propagieren, um die Gewichte präzise anzupassen."

Der Optimierer nutzt diesen Gradienten, um die Gewichte mittels Gradientenabstieg (Gradient Descent) zu aktualisieren. Dieser Zyklus wird tausendfach wiederholt, bis das Netzwerk eine minimale Fehlerrate erreicht. Beachten Sie dabei die Bedeutung der Lernrate, die bestimmt, wie groß die Schritte bei der Anpassung der Parameter sind.

Analyse der Schichtarchitektur

Input Layer

Die erste Schicht nimmt die numerischen Repräsentationen der Eingangsdaten auf. Jedes Neuron entspricht einem Feature des Datensatzes.

  • • Skalierung der Eingangsdaten
  • • Dimensionale Übereinstimmung

Hidden Layers

Hier findet die eigentliche Abstraktion statt. In tiefen Netzen können hunderte dieser Schichten existieren, um komplexe Hierarchien abzubilden.

  • • Feature-Extraktion
  • • Abstraktionsebenen

Output Layer

Die letzte Schicht liefert das Ergebnis, sei es eine Wahrscheinlichkeit für eine Klasse oder ein kontinuierlicher Wert.

  • • Softmax für Klassifizierung
  • • Lineare Ausgabe für Regression

Statistische Relevanz und Fakten

175 Mrd.
Parameter in GPT-3
99.8%
Genauigkeit bei MNIST
100+
Schichten in ResNet
2012
Durchbruch (AlexNet)

Mathematische Aktivierungsfunktionen

Aktivierungsfunktionen entscheiden, ob ein Neuron "feuern" soll oder nicht. Die Wahl der richtigen Funktion beeinflusst die Konvergenzgeschwindigkeit und die Fähigkeit des Modells, komplexe Nichtlinearitäten zu lernen. Hier sind die am häufigsten verwendeten Typen:

01

ReLU (Rectified Linear Unit)

f(x) = max(0, x)

Der aktuelle Standard für Hidden Layers. Sie löst das Problem des verschwindenden Gradienten (Vanishing Gradient Problem) teilweise und ist rechnerisch sehr effizient.

02

Sigmoid / Logistische Funktion

f(x) = 1 / (1 + e^-x)

Wandelt Werte in einen Bereich zwischen 0 und 1 um. Häufig in der Ausgangsschicht für binäre Klassifikationsprobleme zu finden.

03

Tanh (Tangens Hyperbolicus)

f(x) = tanh(x)

Ähnlich wie Sigmoid, liefert aber Werte zwischen -1 und 1. Dies hilft, die Daten um den Nullpunkt zu zentrieren, was das Training oft beschleunigt.

Herausforderungen und Ethik im Deep Learning

Trotz der beeindruckenden Erfolge von Deep Learning in Bereichen wie Bilderkennung und NLP (Natural Language Processing) gibt es signifikante Herausforderungen. Eines der Hauptprobleme ist die mangelnde Interpretierbarkeit. Tiefe neuronale Netze werden oft als "Black Boxes" bezeichnet, da es schwierig ist, die genauen Gründe für eine spezifische Entscheidung nachzuvollziehen. Dies führt zu kritischen Fragen in sicherheitssensiblen Bereichen wie der Medizin oder dem autonomen Fahren.

Ein weiterer Aspekt ist der enorme Bedarf an Rechenleistung und Daten. Das Training moderner Large Language Models (LLMs) erfordert tausende von spezialisierten Prozessoren und verbraucht erhebliche Mengen an Energie. Dies wirft Fragen zur Nachhaltigkeit auf. Zudem besteht das Risiko, dass Modelle Vorurteile (Biases) aus den Trainingsdaten übernehmen und verstärken, was zu diskriminierenden Ergebnissen führen kann.

Wissenschaftler arbeiten daher verstärkt an Methoden der Explainable AI (XAI), um die Entscheidungsprozesse transparenter zu machen. Es ist wichtig zu verstehen, dass die mathematische Optimierung eines Modells nicht zwangsläufig mit menschlicher Logik oder ethischen Standards korreliert. Daher ist eine kritische Prüfung der Ergebnisse und eine fundierte ethische Einordnung unerlässlich für den verantwortungsvollen Einsatz dieser Technologie.
Vertiefen Sie Ihr Wissen

Die Welt der künstlichen Intelligenz entwickelt sich rasant. Informieren Sie sich über die neuesten Trends und die Zukunft der allgemeinen künstlichen Intelligenz (AGI).